
2026/11/09 05:00Solution Knowledge
検証レポート「ビジネスメタデータ整備がAIエージェントの回答精度に与える影響」Solution Knowledge
生成AIはなぜ社内データを正しく読めないのか?AIエージェントの回答精度を左右する「ビジネスメタデータ」の重要性
「社内データを自然言語で検索・分析させたいが、期待した通りのSQLやデータが返ってこない――」
生成AI(LLM)やAIエージェントを業務基盤に導入しようとする多くの企業が、このような「解釈精度の壁」に直面しています。
モデルの性能向上だけでは解決が難しいこの課題に対し、Quollio Technologiesは「メタデータの整備状況がAIエージェントの回答精度にどれほど寄与するのか」を定量評価するPoC検証を実施しました。
本記事では、合計180ケースに及ぶテストから導き出された重要インサイトをダイジェストでご紹介します。
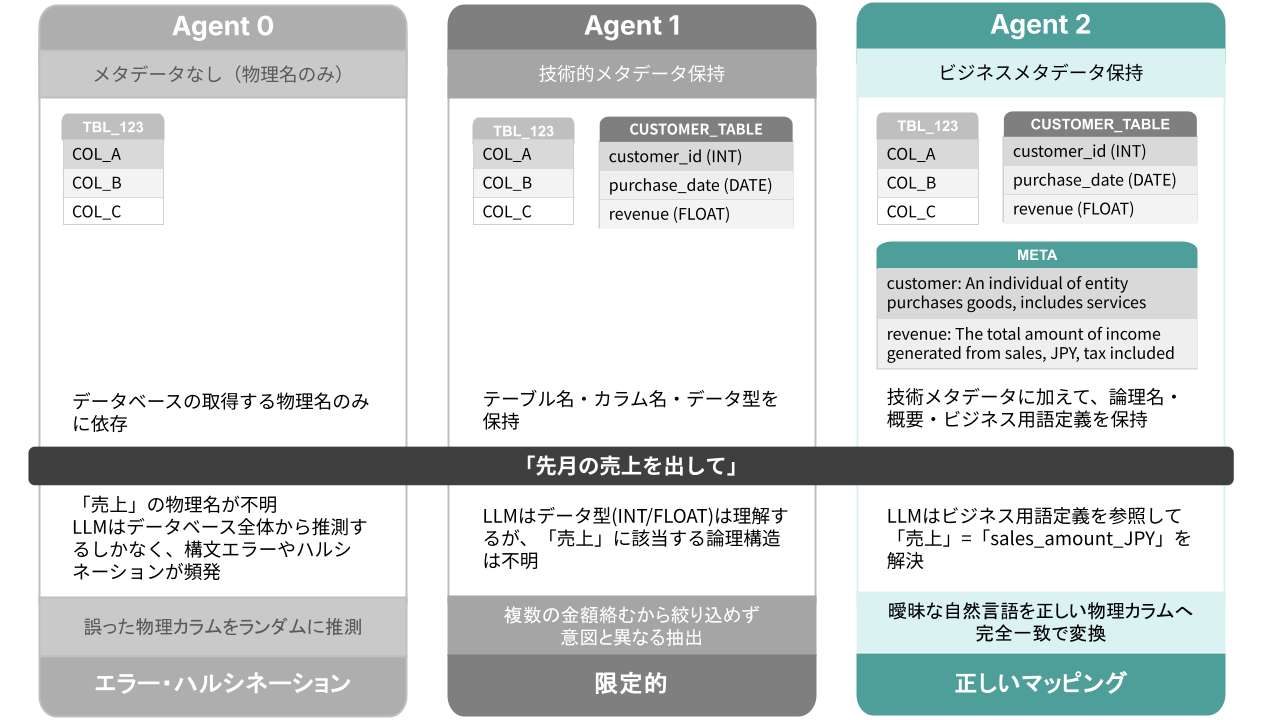
本検証では、クラウドDWH環境において保持するメタデータの種類・量が異なる3種類のAIエージェントを用意し、同一プロンプトに対する実行正確性・コンテキスト正答率を比較測定しました。
※ 「コンテキスト正答率」は、意図・文脈の解釈が正しかったかを判定するものであり、出力そのものが完全に一致したことを示すものではありません。
ユーザーからの「先月の売上を出して」という自然言語指示に対し、各エージェントの挙動には大きな差が生じました。
データベースの物理名や型情報だけでは、業務で交わされる言葉との「意味のギャップ」を埋められないことが実証されました。
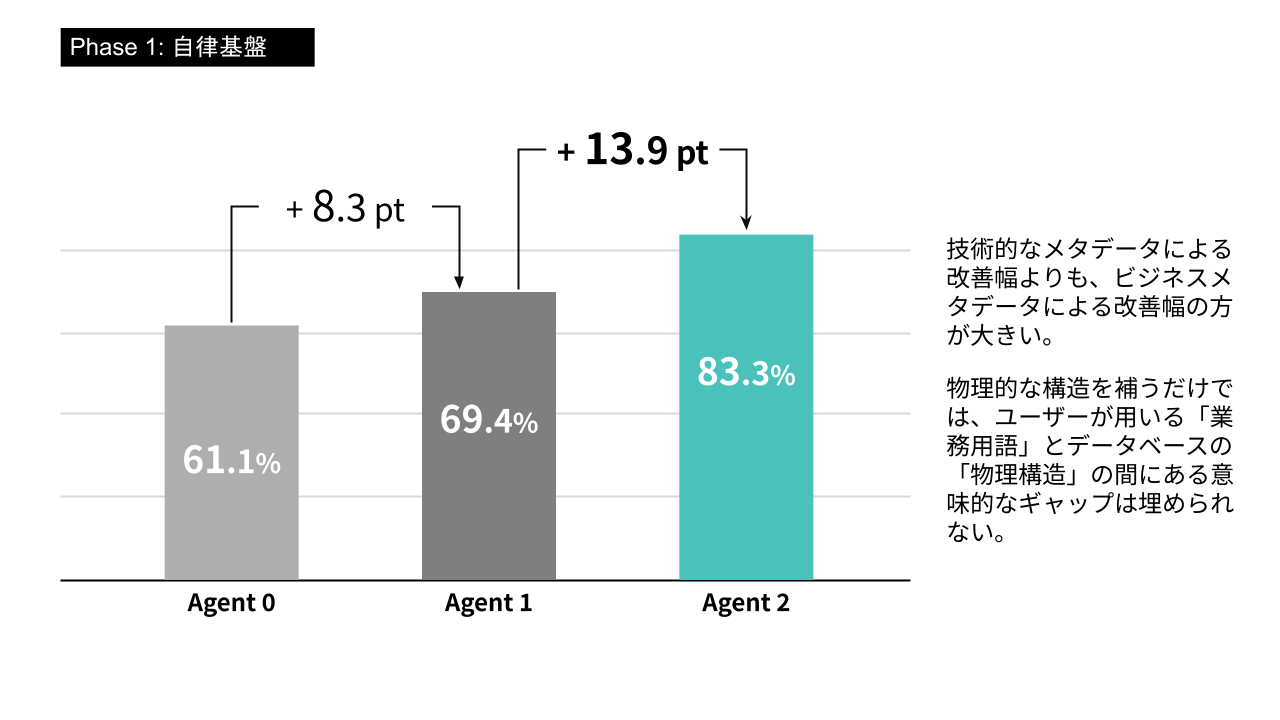
第1段階(自律基盤)におけるコンテキスト正答率の検証では、技術メタデータ追加による改善幅が+8.3 pt(61.1% ➜ 69.4%)だったのに対し、ビジネスメタデータの追加は+13.9 pt(83.3%)と大きく上回りました。
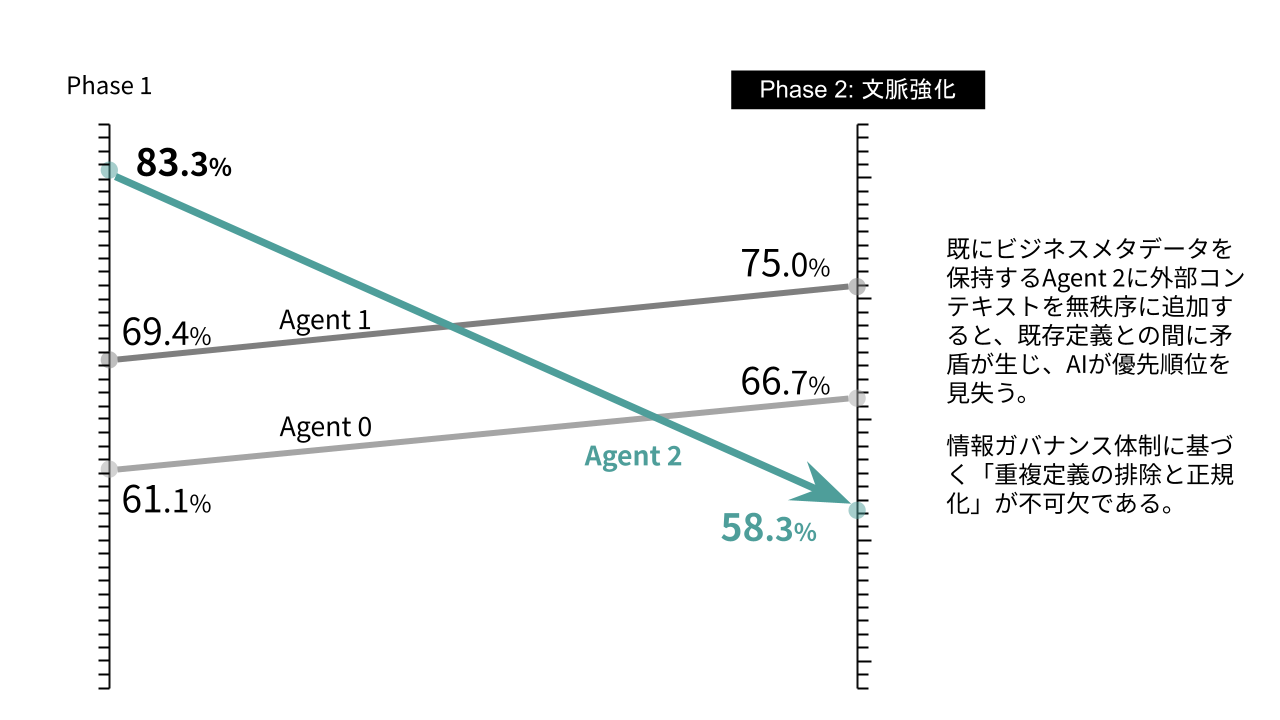
外部から用語集を無秩序に追加した第2段階では、すでに定義を持っていたAgent 2の正答率が一時的に低下(83.3% ➜ 58.3%)しました。定義の重複や矛盾によってAIが優先順位を見失うためであり、データカタログを唯一の正(Single Source of Truth)とするガバナンスと正規化プロセスが不可欠です。
人間が介在して確認を行う第3段階では、Agent 2がコンテキスト正答率100.0%を記録したのに対し、Agent 0は50.0%にとどまりました。AIが「自らの解釈の曖昧性を検知して人間に確認を求める」ためにも、前提となるメタデータ基盤が欠かせません。
生成AI活用を実務の成果に結びつけるための鍵は、モデルのアップグレードではなく、データカタログを通じたビジネスメタデータの整備とガバナンスにあります。
公開中の検証レポート全文(PDF・全14ページ)では、以下の詳細データを網羅して掲載しています。
データインテリジェンスに関して、今後の進め方のご相談やデモをご希望の方は、お気軽にお問い合わせください。